Fusion w Devin – dwa modele, cena jednego
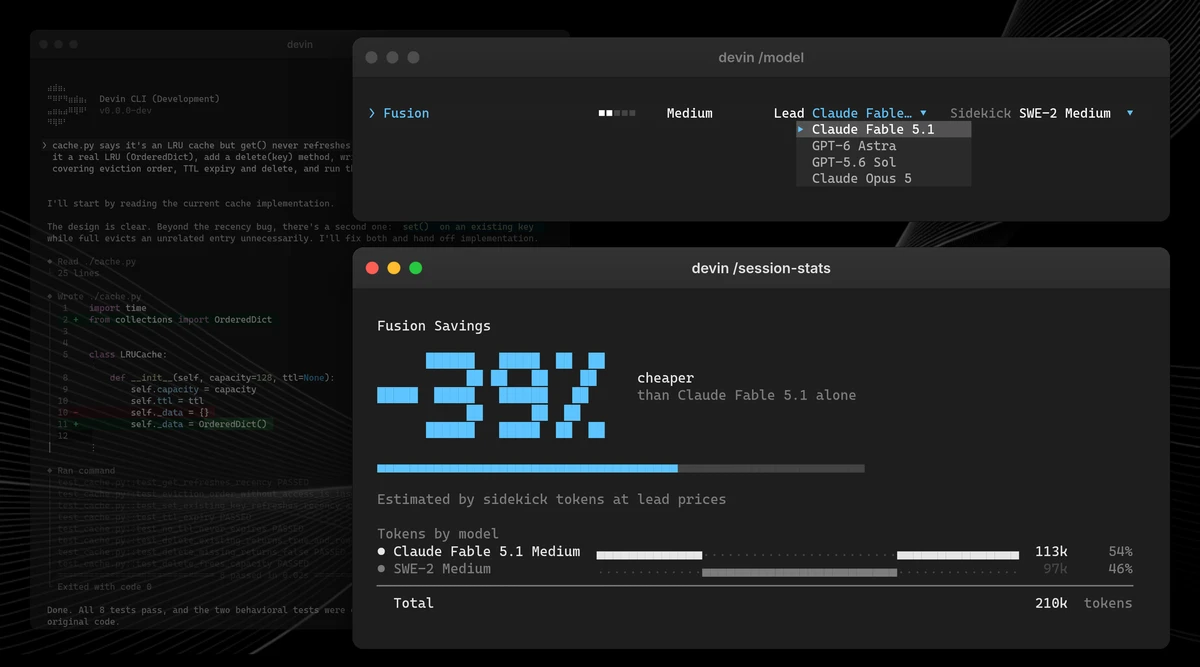
Fusion to nowa architektura w Devin Desktop i CLI: frontier model planuje i weryfikuje, tańszy sidekick wykonuje. Do 39% oszczędności przy zachowaniu jakości frontier.
Cognition wypuścił Fusion w Devin Desktop i CLI. To architektura dwóch agentów: frontier model prowadzi sesję i planuje, a tańszy sidekick wykonuje. Wynik? Do 39% oszczędności przy zachowaniu jakości frontier na benchmarkach kodowania.
Czym jest Fusion?
Fusion to harness — sposób zarządzania modelami w agencie. Zamiast jednego modelu do wszystkiego, wybierasz dwa:
- Lead — frontier model (np. Fable 5.1 lub Astra), który prowadzi sesję, planuje, interpretuje niejasności i weryfikuje pracę.
- Sidekick — tańszy, efektywny model (np. SWE-2), któremu lead deleguje konkretne zadania: eksplorację kodu, implementację, uruchamianie testów.
Rekomendowane parowanie to Fable 5.1 + SWE-2. To połączenie daje najlepszy stosunek jakości do ceny.
Jak to wygląda w CLI
Przy uruchomieniu sesji w Devin CLI wybierasz Fusion, a następnie wskazujesz lead i sidekick. Lead pozostaje interfejsem dla użytkownika — zawsze rozmawiasz z frontier intelligence.
Oszczędności na benchmarkach
Cognition współpracował z Artificial Analysis i Vals AI, żeby zbadać Fusion na benchmarkach kodowania. Wyniki są spójne — Fusion utrzymuje jakość frontier przy znacznie niższych kosztach:
| Benchmark | Fable 5.1 | Fusion (Fable 5.1 + SWE-2) | Astra | Fusion (Astra + SWE-2) |
|---|---|---|---|---|
| DeepSWE 1.1 | 64.3 / $14.63 | 63.1 / $7.88 (−46%) | 67.6 / $7.88 | 67.3 / $4.69 (−40%) |
| Terminal-Bench 4 | 57.6 / $17.46 | 56.1 / $13.37 (−23%) | 55.6 / $10.08 | 50.0 / $6.06 (−40%) |
| SWE-Atlas QnA | 64.8 / $7.57 | 65.9 / $5.00 (−34%) | 61.8 / $5.72 | 59.4 / $3.59 (−37%) |
| Vals Code Migration | 54.6 / $70.97 | 57.3 / $42.00 (−41%) | 67.7 / $44.36 | 61.3 / $35.51 (−20%) |
| FrontierCode 1.1 (Ext.) | 63.6 / $2.68 | 63.5 / $1.67 (−38%) | 63.1 / $2.62 | 63.4 / $2.34 (−11%) |
Format: wynik / koszt. Fusion w kilku przypadkach nawet poprawił wynik przy jednoczesnym obniżeniu kosztów.
Dlaczego zwykły routing nie wystarcza
Model routing — przydzielanie zadań do tańszych modeli na podstawie trudności — wydaje się sensowne, ale ma problem: nie wiesz, jak trudne jest zadanie, zanim je zaczniesz. „Napraw błąd xyz" może być zmianą jednej linii albo przebudową całej architektury.
Dodatkowo, przełączanie modeli w trakcie zadania psuje cache promptów — to kosztuje więcej tokenów dla modelu frontier i niweczy sens oszczędności.
Architektura Fusion
Fusion rozwiązuje te problemy prostym pomysłem: dwa równoległe agenty, każdy z własnym kontekstem i narzędziami. Lead i sidekick nie przekazują sobie całych konwersacji — wymieniają tylko briefy, wyniki i feedback.
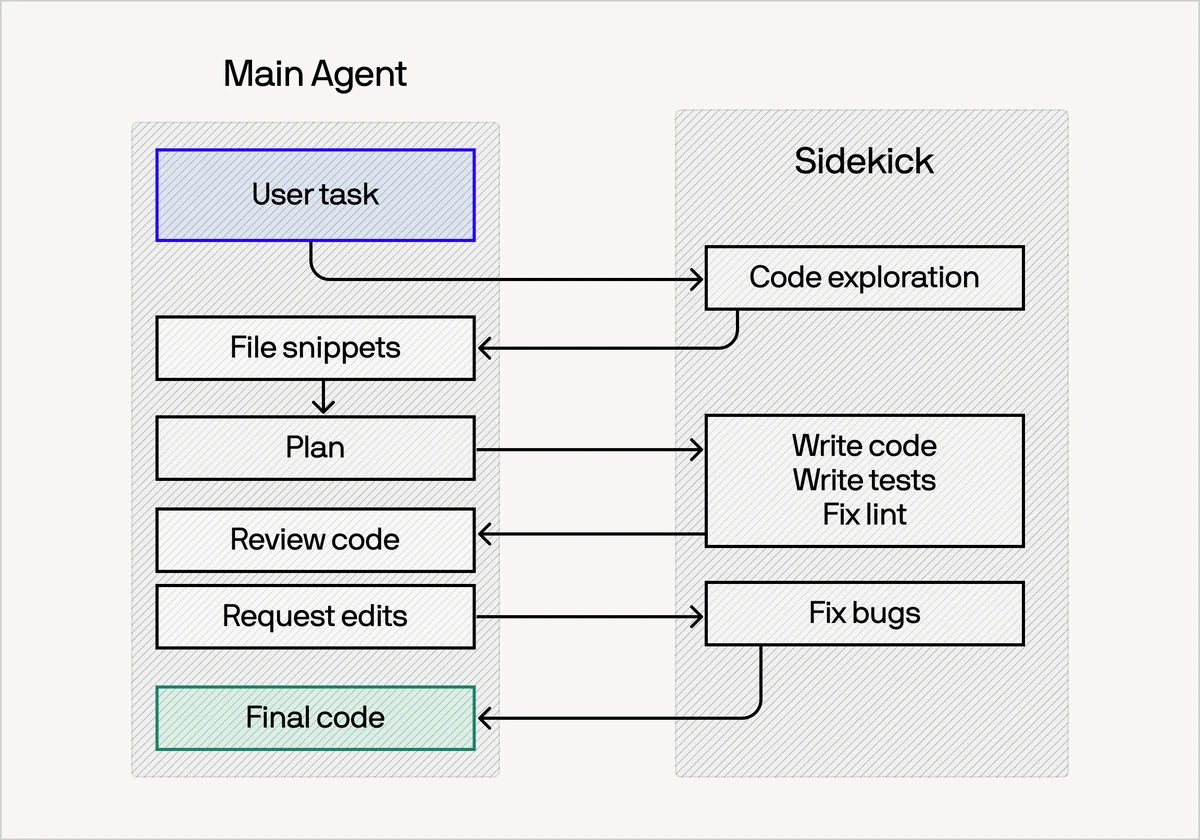
Sidekick nie potrzebuje całej historii leada, żeby zaimplementować zmianę. Lead nie potrzebuje każdego wyniku narzędzia sidekicka, żeby zweryfikować pracę. Każdy agent buduje własny kontekst i w pełni korzysta z cache promptów.
Kluczowa zaleta: frontier intelligence zawsze prowadzi. Nie ma ryzyka, że tańszy model dostanie zadanie przekraczające jego możliwości — lead zawsze weryfikuje pracę i może przejąć kontrolę, gdy sidekick sobie nie radzi.
Droższy model może być tańszy
To jeden z najciekawszych wniosków z pracy nad Fusion: cena za token to tylko część równania. Frontier modele są coraz bardziej efektywne — potrzebują mniej tokenów i mniej rund back-and-forth z sidekickiem.
Cognition zastąpił Opus 4.8 Fable 5 jako leadem. Fable nominalnie kosztuje dwa razy więcej za token, ale sesje z Fable były średnio 9% tańsze i dawały wyższe wyniki na FrontierCode. Dlaczego? Fable delegował wcześniej i dawał lepsze briefy, a Opus mikromanaged sidekicka i przepisywał jego pracę.
To samo działa dla sidekicka. Silniejszy SWE-2 zamiast tańszego GPT-5.6 Luna nie zwiększa znacząco kosztu, bo:
- Silniejszy sidekick jest bardziej efektywny — mniej prób, mniej tokenów na poprawki.
- Jego praca wymaga mniej rund weryfikacji od leada — oszczędza tokeni frontier modelu.
W 2026 roku modele powinno oceniać się po cenie za zadanie, nie po cenie za token.
Strojenie harnessu pod pary modeli
Wybranie leada i sidekicka to nie wszystko. Instrukcje, które pomagają jednej parze, mogą zaszkodzić innej. Cognition stroji harness odpowiadając na trzy pytania dla każdej pary:
- Ile szczegółów lead ma przekazać? Z słabszym sidekickiem Fable 5.1 musi dawać bardziej szczegółowe briefy. Z SWE-2 może zostawić więcej swobody.
- Czy sidekick może się sprzeciwiać? Silniejsze sidekicky powinny móc kwestionować plan leada. Słabsze — nie, bo to szkodzi wydajności.
- Co delegować? Eksploracja potrzebna do planowania nie powinna trafiać do słabszego sidekicka. Silniejsze mogą wspierać wstępną eksplorację.
Jak spróbować
Fusion jest dostępny w Devin Desktop i CLI. Aby zainstalować CLI:
curl -fsSL https://cli.devin.ai/install.sh | bashPo uruchomieniu sesji wybierz Fusion, wskaż lead (np. Fable 5.1) i sidekick (np. SWE-2). Reszta dzieje się automatycznie.
Źródło: cognition.com/blog/local-fusion