Jev: model typowanych decyzji od TypeSafe i jego otwarte wersje na Hugging Face
Jev od TypeSafe AI nie generuje tekstu. Zwraca typowane decyzje: choice, score i noul z prawdopodobieństwami. API jest publiczne od 21 września, a na Hugging Face pojawiły się już otwarte odpowiedniki JEV-9B i JEV-27B.
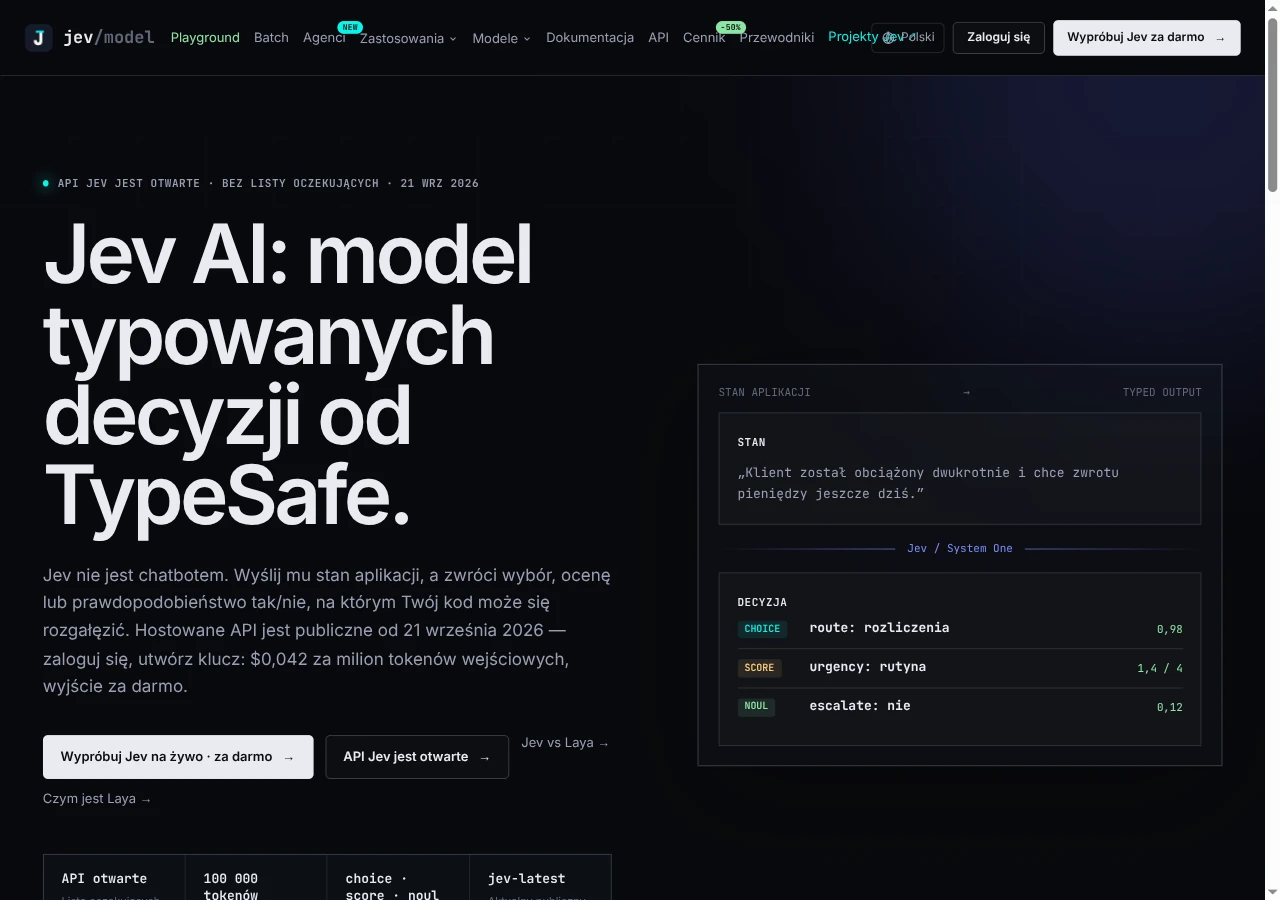
Większość nowych modeli AI to kolejne chatboty albo generatory kodu. Jev od TypeSafe AI idzie w drugą stronę: nie generuje tekstu, tylko typowane decyzje. Wysyłasz stan aplikacji, a dostajesz wybór, ocenę lub skalibrowane prawdopodobieństwo tak/nie, na którym kod może się rozgałęzić. Hostowane API jest publiczne od 21 września 2026, a na Hugging Face pojawiły się już otwarte odpowiedniki, które odwzorowują rozkłady prawdopodobieństw oryginału.
Czym jest Jev i czym różni się od LLM?
Jev to flagowy model TypeSafe AI z kategorii, którą nazywają System One. Podobnie jak człowiek intuicyjny „System 1", ma odpowiadać szybko i przewidywalnie, bez długiego rozumowania. Różnica względem LLM jest fundamentalna: Jev nie prowadzi rozmowy i nie pisze esejów. Na wejście dostaje stan aplikacji (tekst albo JSON) i zestaw pytań o określonych typach, a na wyjściu zwraca jedną z trzech struktur z prawdopodobieństwami:
- choice: wybór jednej opcji ze znanego zbioru (od 2 do 16 pozycji), np. routing zgłoszenia do działu rozliczeń;
- score: ocena na uporządkowanej skali 0-5, np. pilność zgłoszenia;
- noul: skalibrowane prawdopodobieństwo dla pytania tak/nie, np. „czy eskalować do człowieka?".
Aktualna wersja to Jev 1.13 (identyfikator jev-1.13.0). TypeSafe udostępnia też aliasy jev-latest i jev-preview, które wskazują najnowsze wydanie i zmieniają się po publikacji nowej wersji. Jeśli progi pewności w Twoim kodzie dostroisz pod konkretną wersję, TypeSafe zaleca przypięcie wersjonowanego identyfikatora.
Hostowane API: cena i praktyka
API Jev jest publiczne od 21 września 2026, bez listy oczekujących. Dokumentowany endpoint to POST https://api.typesafe.ai/v1/systemone. Cennik jest nietypowy: 0,042 dolara za milion tokenów wejściowych, tokeny wyjściowe bezpłatne. To logiczne, skoro model zwraca krótką, typowaną strukturę, a nie stronę tekstu. TypeSafe deklaruje opóźnienia 70-500 ms od początku do końca żądania, przy czym większość zapytań ma zamykać się w około 100 ms.
Na start nie trzeba nic płacić: playground przyjmuje 10 000 tokenów wejściowych bez rejestracji, a 100 000 po zalogowaniu. Pakiety tokenów zaczynają się od 9,90 dolara. Jedno zastrzeżenie dla polskich użytkowników: Jev jest trenowany głównie na angielskim. Polski działa, ale dokładność jest nieco niższa.
Gdzie to się sprawdza? Tam, gdzie workflow ma już LLM-a, API albo agenta, ale potrzebuje małej, niezawodnej gałęzi przed kolejnym krokiem: routing modeli AI, zabezpieczenia wywołań narzędzi, triage wsparcia, ocena wyników RAG. Zamiast pytać dużego modelu „czy to zgłoszenie jest pilne?" i parsować odpowiedź tekstem, wysyłasz stan do Jev i rozgałęziasz kod na gotowym prawdopodobieństwie.
Jev jest zamknięty. Społeczność odpowiedziała otwartymi klonami
Sam model TypeSafe nie publikuje wag. Nie ma oficjalnego wydania na Hugging Face ani możliwości self-hostingu. To nie przeszkodziło społeczności: w ciągu kilku tygodni od premiery API powstały dziesiątki otwartych reprodukcji, a niezależny Jev Decision Index ocenia już 55 z nich. Najgłośniejszą rodziną są modele JEV od AutoTrust AI Lab, dostępne na Hugging Face na licencji Apache 2.0:
- autotrust/JEV-9B (18 GB), zbudowany na bazie Qwen3.5-9B;
- autotrust/JEV-27B (54 GB), zbudowany na bazie Qwen3.8-27B.
Ważne dla uczciwości nazewnictwa: to nie są oficjalne wagi Jev. AutoTrust wytrenował je metodą destylacji z publicznych rozkładów wyjściowych Jev 1.13, na otwartym korpusie jev-distill-corpus-v3. Model jest niezależny od TypeSafe i nie dzieli z nim ani wag, ani kodu.
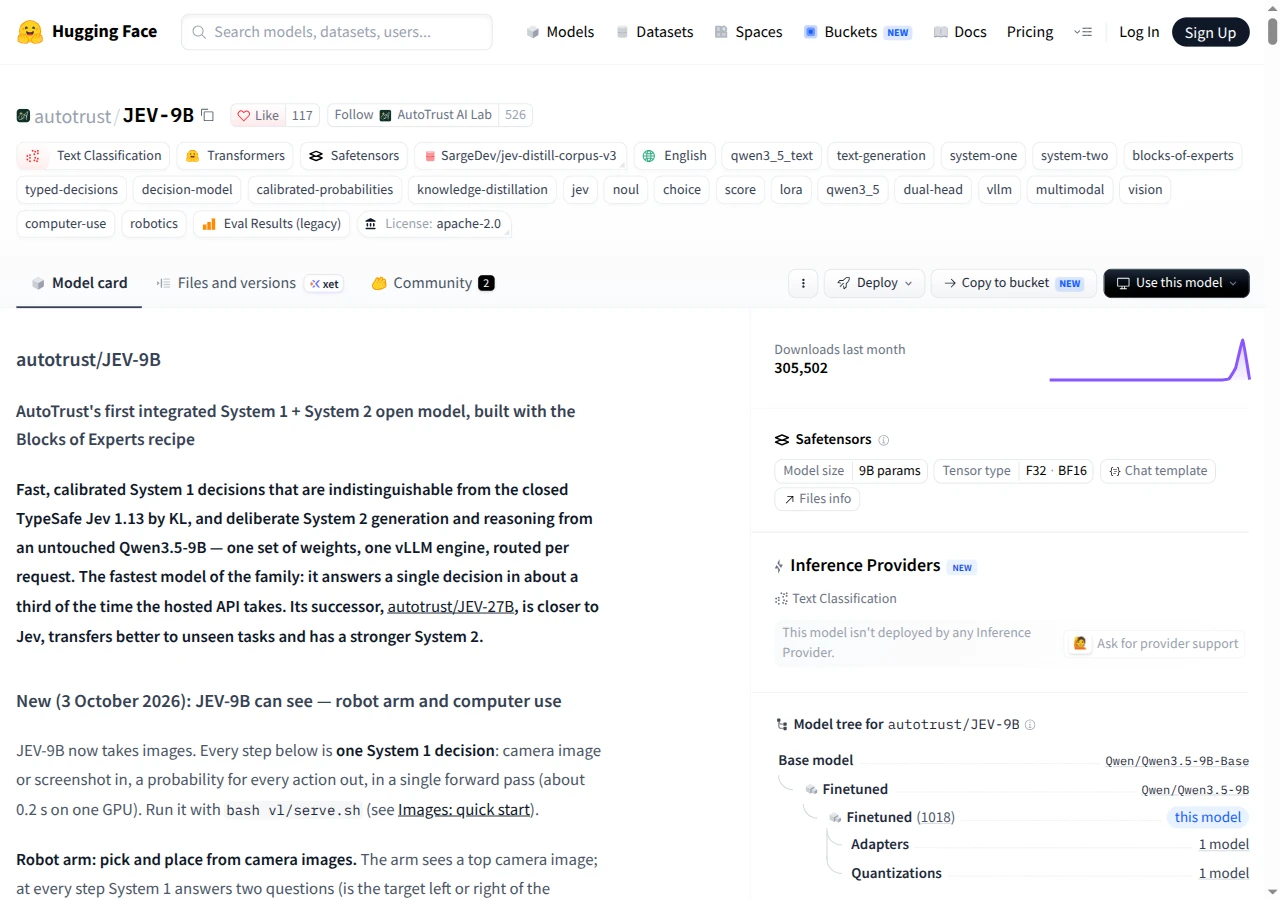
Jak zbudowano JEV-9B: Blocks of Experts
Najciekawszy pomysł techniczny w JEV-9B to receptura Blocks of Experts. Zamiast dostrajać cały model, AutoTrust zostawił backbone Qwen3.5-9B nietknięty (wagi bitowo identyczne z wydaniem Qwen) i dołożył mały, odłączany blok eksperta odpowiedzialny za decyzje System One. Ten blok to 40,2 mln parametrów, czyli 0,5% rozmiaru backbone, wytrenowane w około 3 godziny na jednej karcie B200.
Dzięki temu dodanie „mózgu decyzyjnego" nie kosztuje jakości generowania: HumanEval wynosi 70,7% przed i po dołożeniu bloku, a wszystkie 164 uzupełnienia kodu jest identycznych bajt w bajt. Według autorów złożenie tego samego bloku wprost w backbone kosztowałoby 9 punktów na tym benchmarku. Model obsługuje oba tryby z jednego zestawu wag: System 1 (szybkie typowane decyzje) i System 2 (zwykłe generowanie tekstu z rozumowaniem), a żądanie samo wybiera system.
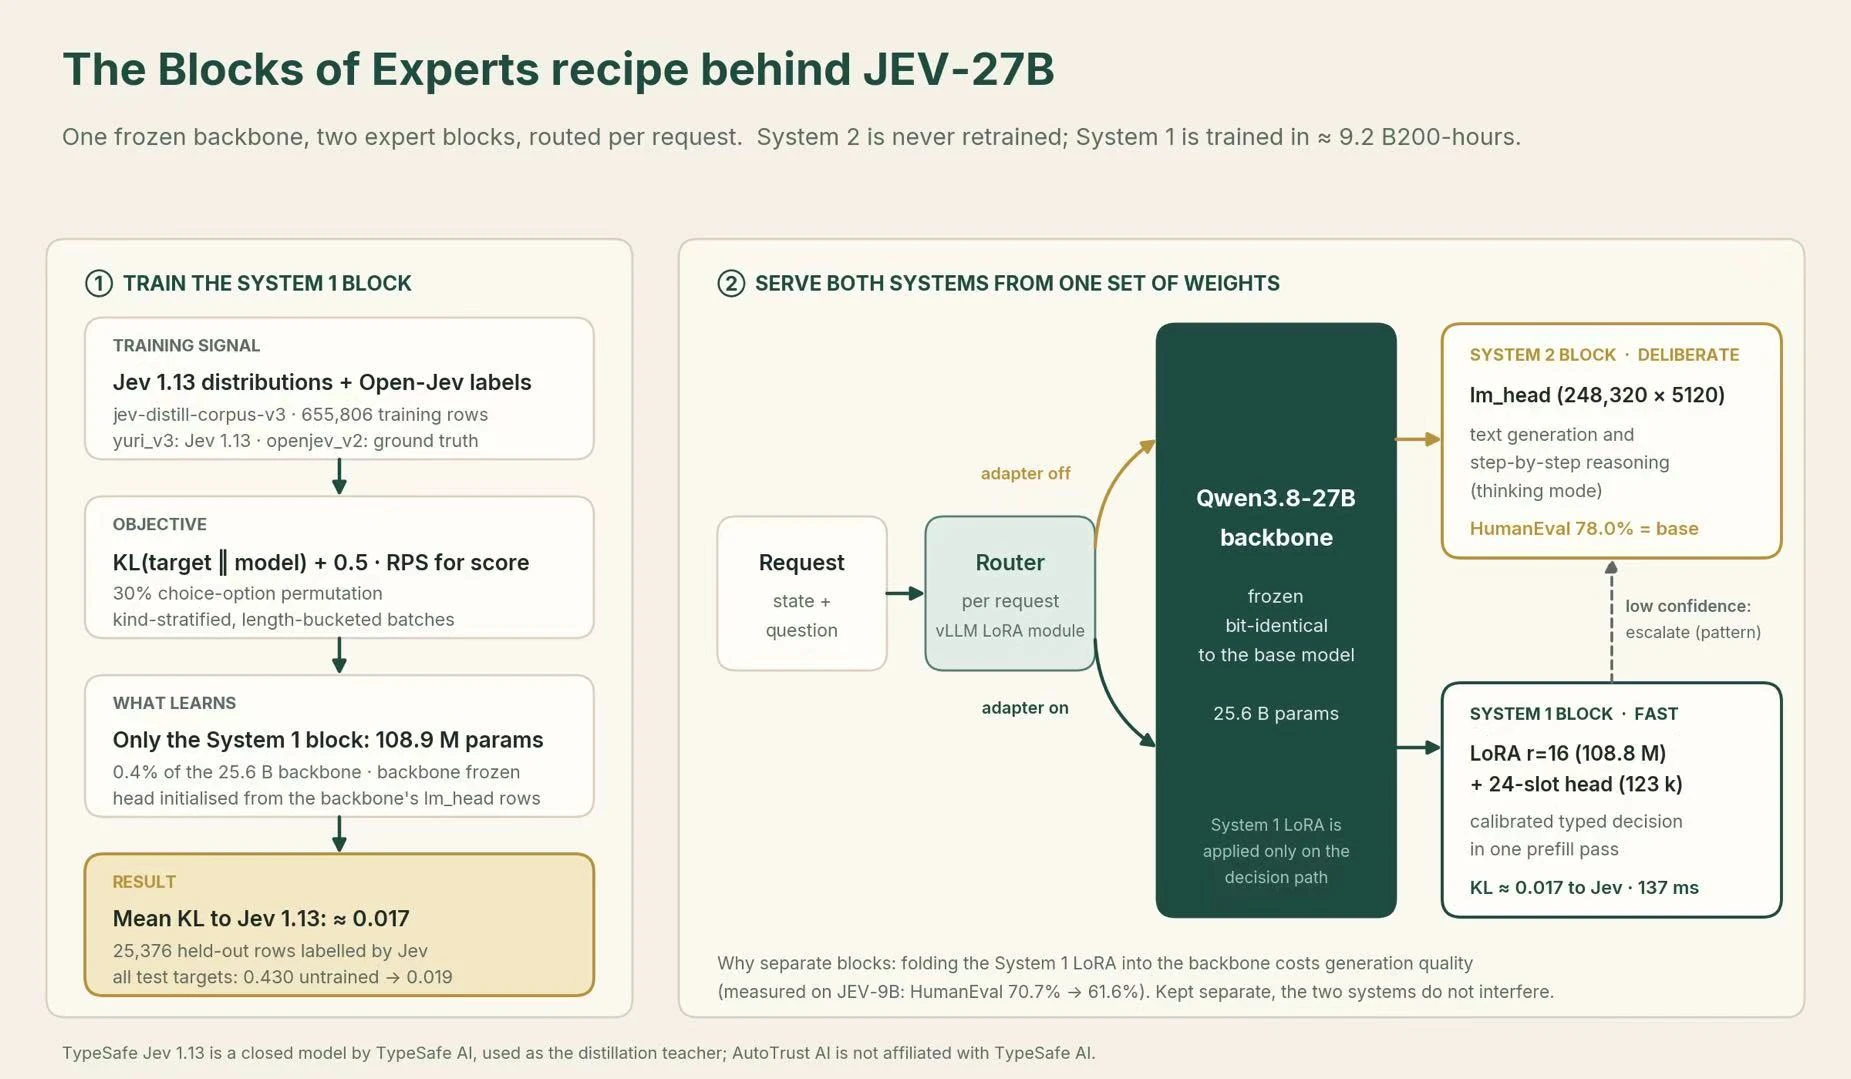
Receptura Blocks of Experts za JEV-27B: trening bloku System 1 na rozkładach Jev 1.13 (po lewej) i obsługa obu systemów z jednego zestawu wag (po prawej). Źródło: karta modelu autotrust/JEV-27B.
Jak blisko oryginału? Porównanie
O wierności najlepiej świadczy dywergencja KL między rozkładami prawdopodobieństw studenta i nauczyciela, liczona na 25 376 pytań testowych z 53 dziedzin. Wartość 0 oznacza identyczność. JEV-9B osiąga około 0,019, a większy JEV-27B około 0,017. W praktyce oznacza to, że obserwując próbkowane decyzje, trudno odróżnić, który model ich udzielił.
| Parametr | JEV-9B | JEV-27B | Jev 1.13 (host) |
|---|---|---|---|
| Rozmiar wag | 18 GB | 54 GB | tylko API |
| Średnia dywergencja KL do rozkładów Jev | ~0,019 | ~0,017 | wzorzec (0) |
| Zgoda top-1 z Jev (choice) | 90,2% | 90,5% | 100% |
| HumanEval pass@1 (System 2) | 70,7% | 78,0% | nie dotyczy |
| Latencja pojedynczej decyzji | ~90 ms (B200) | 137 ms (B200) | 238-301 ms (pomiar niezależny) |
| Licencja | Apache 2.0 | Apache 2.0 | zamknięta |
Dane: karta modelu autotrust/JEV-9B (stan na 5 października 2026). Latencje modeli otwartych mierzono na jednej karcie NVIDIA B200; latencja hostowanego API pochodzi z niezależnego pomiaru cytowanego w karcie.
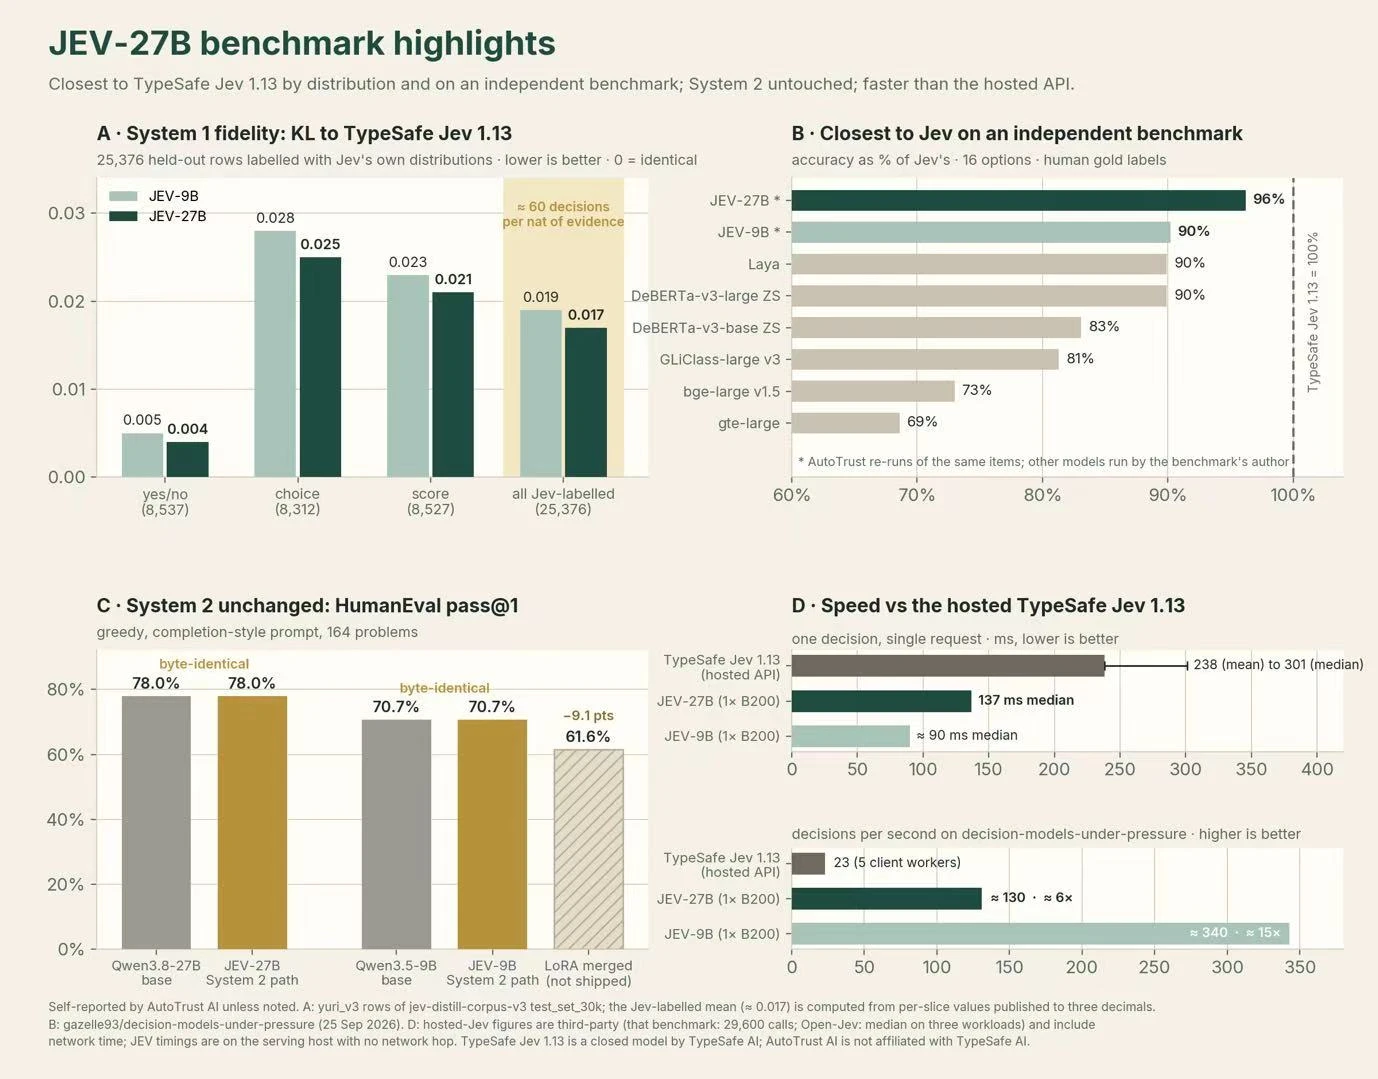
Wyniki JEV-9B i JEV-27B w czterech ujęciach: wierność rozkładom Jev 1.13, dokładność względem nauczyciela, nienaruszony System 2 i szybkość decyzji. Źródło: karta modelu autotrust/JEV-27B.
Otwarty JEV-9B odpowiada więc na pojedynczą decyzję około trzykrotnie szybciej niż hostowane API i utrzymuje około 15-krotnie wyższą przepustowość decyzji na sekundę na jednej karcie. W niezależnym benchmarku z 16 opcjami JEV-9B zachowuje 90% dokładności nauczyciela, a JEV-27B aż 96%. Kiedy wybrać który? Do routingu, moderacji i triage z krótkimi listami opcji wystarczy JEV-9B, jest 2,6 raza szybszy. Przy długich listach opcji, sprawdzaniu reguł w kodzie, wykrywaniu oszustw i zadaniach spoza znanych rodzin lepiej sprawdza się JEV-27B, który na niewidzanych typach zadań ma wyraźnie niższą dywergencję KL (0,104 wobec 0,234).
Nowość z 3 października: JEV-9B widzi obrazy
W pierwszych dniach października AutoTrust dodał do JEV-9B obsługę wizji. Każdy krok to nadal jedna decyzja System One: obraz z kamery lub zrzut ekranu na wejściu, prawdopodobieństwo dla każdej akcji na wyjściu, w jednym przejściu sieci (około 0,2 s na jednej karcie). W demo z ramieniem robota (symulacja MuJoCo) model poprowadził chwytanie i odkładanie kostki w 10 na 20 losowych scen, a każde złapane kostki trafiło do pojemnika. W teście użycia przeglądarki (headless Chromium) model ukończył 95% z 60 losowych zadań wieloetapowych, decydując o kolejnym kliknięciu na podstawie numerowanych ramok elementów.
Pozostałe otwarte odpowiedniki
Rodzina JEV to nie jedyna droga. Laya od Convai Innovations to niezależny model decyzji na licencji Apache 2.0 z tym samym zestawem prymitywów (choice, score, noul). OpenJEV odwzorowuje kształt żądań /v1/systemone, ale na licencji niekomercyjnej CC BY-NC 4.0. Są też modele celujące w wyższą dokładność niż oryginał zamiast wierności rozkładom, np. AutoJev-27B czy decider-4b, i to one prowadzą w społecznościowych rankingach JevBench. Wybór zależy od tego, czego potrzebujesz: jeśli chcesz „Jev, ale u siebie na GPU", liczy się wierność rozkładów (rodzina JEV); jeśli chcesz po prostu taniego klasyfikatora decyzji, wystarczy każdy dobry model z Decision Index.
Na co uważać
- Nazwy są mylące. „Jev" to zamknięty model TypeSafe. „JEV-9B", „OpenJEV" i „Laya" to niezależne projekty. Żaden z nich nie jest oficjalnym, samodzielnym Jevem.
- Destylacja dziedziczy też błędy. AutoTrust otwarcie pisze, że wierność rozkładom obejmuje również pomyłki nauczyciela.
- Wyniki są w większości samoraportowane. Niezależny benchmark z 16 opcjami potwierdza poziom dokładności, ale Decision Index i JevBench nie oceniły jeszcze modeli JEV.
- Polski działa gorzej niż angielski, zarówno w hostowanym Jevie, jak i w klonach destylowanych z jego wyjść.
Jak spróbować
Najszybsza droga to playground Jev (10 000 tokenów bez rejestracji). Jeśli wolisz wersję otwartą, pobierz model z Hugging Face:
hf download autotrust/JEV-9B --local-dir JEV-9B
vllm serve JEV-9B --served-model-name autotrust/JEV-9B     --enable-lora --max-lora-rank 32 --lora-modules jev-decision=JEV-9B/adapter_vllm     --logprobs-mode processed_logprobs --max-model-len 4096
Do testów lokalnych wystarczy jedna karta z 24 GB VRAM dla wariantu 9B. Jeśli nie masz GPU, zostaje hostowane API za 0,042 dolara za milion tokenów wejściowych albo darmowe 100 000 tokenów po zalogowaniu.
Źródła: karta modelu autotrust/JEV-9B na Hugging Face, niezależny przewodnik Jev Model Guide, wiki Jev